栏目:决策陷阱 | 标签:幸存者偏差、样本偏差、满意度调研、NPS、流失预警
关于本文的数据说明
文中 2000 家客户、32% 回收率等数字,是为讲清机制而构造的示意数据,经过简化和取整,不指向任何具体公司。开头的评分类比同理,用的是生活经验,不是任何平台的真实统计。
但所有比例关系、四象限对比和滞后结构的计算都是真实的,你可以用自己公司的数字替换后,得到同样形状的结论。
先看一个你一定遇到过的现象
打开外卖 App,随便翻几页。
你会发现一件事:几乎每家店都在 4.5 分以上。 4.2 分的店你已经觉得”是不是有问题”,4.0 分以下的店简直是奇迹。
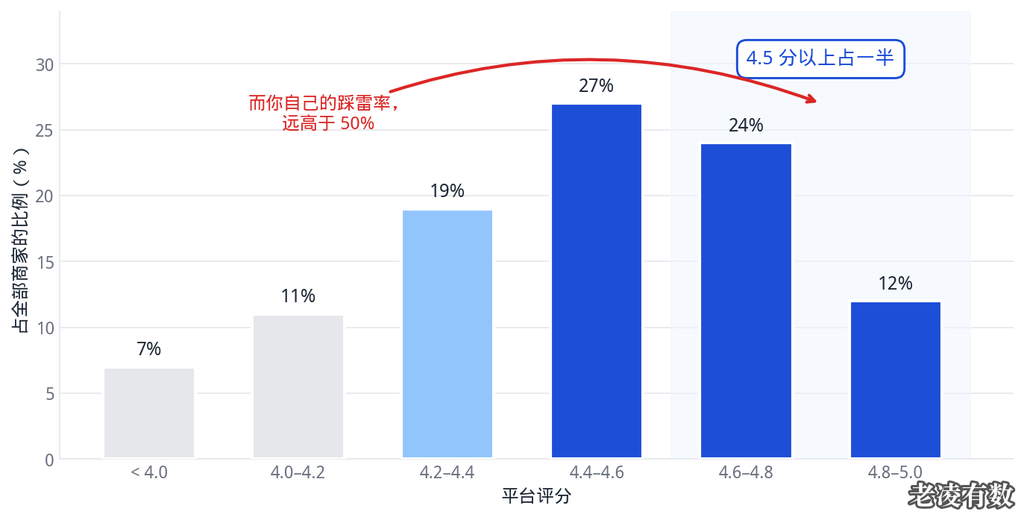
图 1 | 平台上的评分分布普遍偏高,4.5 分以上占了一半
但你关掉 App 想一想自己过去一个月的点单经历——踩雷率真的只有百分之十几吗?恐怕远高于此。
这不是平台造假,也不是商家刷分(虽然也有)。真正的原因是:打分这个动作本身,就把失望的人过滤掉了。
一家店让你失望,你的反应是——下次不点这家了。你不会专门打开 App,找到那家店,给它打两星。你用脚投票,而不是用手打分。 而那些特意回去打分的人,要么是特别满意想夸一句,要么是愤怒到非要泄愤不可——后者的比例远低于前者。
所以平台上的评分,本质上统计的不是”这家店好不好”,而是”在还愿意给这家店打分的人里,觉得它好不好“。
这句话,请你记住。因为接下来它在商业场景里会制造一个大得多的麻烦。
场景:一份 92% 好评的客户调研
季度末,客户成功团队交上来一份调研报告。
封面页三个数字加粗:
- 满意度 92%
- NPS 45,比上季度涨了 3 个点
- 服务响应评分 4.6 / 5
会议室里气氛不错,有人说了句”看来上个季度的服务改进见效了”,然后翻到下一页议题。
下一个季度结束,这批核心客户流失了 48.1%。
——不是预测错了。是那三个数字从一开始就没有回答”我们的客户会不会走”这个问题。它们回答的是另一个问题:在还愿意搭理我们的客户里,有多少人觉得我们不错。
和外卖评分一模一样的结构。
一、92% 这个数字没有算错,是分母错了
先把这份报告的算术拆开。
2000 家核心客户收到了问卷,回收 640 份,回收率 32%。在这 640 份里,92% 表示满意。
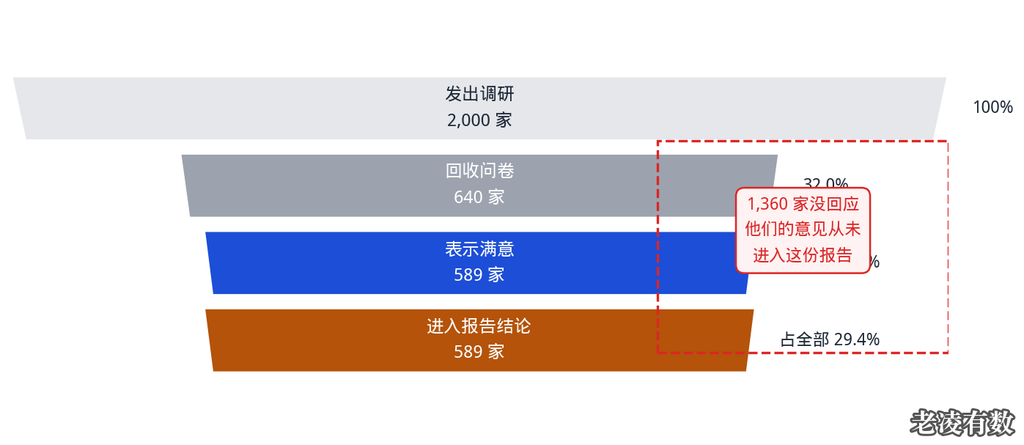
图 2 | 从 2000 家到 589 家:报告的分母只有最上面那一层
分子分母都没错。92% 是一个正确的数字——它的分母是 640。
问题在于,读报告的人(包括写报告的人)在心里默认的分母是 2000。
那么剩下 1360 家没回应的客户,满意率是多少?事后通过流失访谈和行为数据回溯,是 41%。
把两层合起来算真实的整体满意率:
回应者中满意:   640 × 92% = 589 家
未回应者中满意:1360 × 41% = 558 家
────────────────────────────────
总计满意:      1147 / 2000 = 57.3%
57.3%,不是 92%。
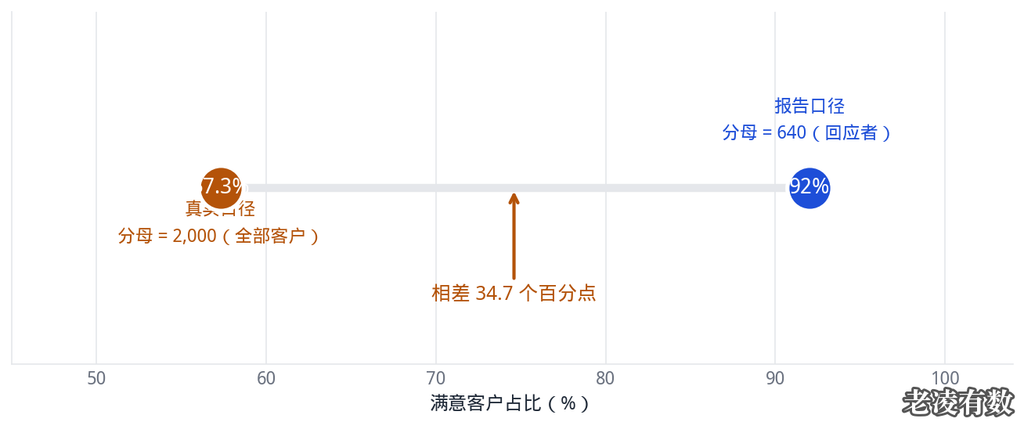
图 3 | 同一个”满意率”,换个分母差出 34.7 个百分点
这不是一个小误差。这是一个足以让整个季度的资源投放方向反过来成立的误差。
这里有一句值得记住的话,我在后面还会重复它:
任何一个百分比,在你知道它的分母之前,都没有意义。
而”分母是谁”这件事,恰恰是报告里最常被省略的一行小字。
二、真正致命的对比:62% vs 30%
如果只是”低估了满意度”,事情还不算严重——无非是高兴得早了点。真正的问题在下一步。
把客户按两个维度交叉:有没有回应问卷 × 满意还是不满意,得到四类。然后看每一类在一个季度后的实际流失率。
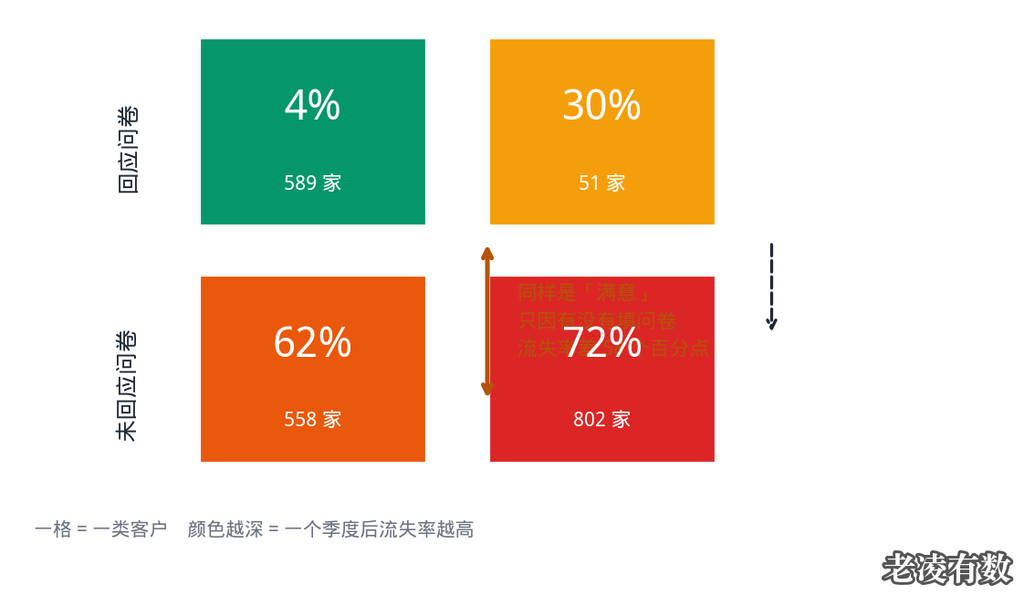
图 4 | 一格一类客户,颜色越深表示流失率越高
| 分组 | 客户数 | 季度流失率 | 流失数 |
|---|---|---|---|
| 回应 · 满意 | 589 | 4% | 24 |
| 回应 · 不满意 | 51 | 30% | 15 |
| 未回应 · 满意 | 558 | 62% | 346 |
| 未回应 · 不满意 | 802 | 72% | 578 |
| 合计 | 2000 | 48.1% | 962 |
请盯着第二行和第三行看三秒钟:
- 回应者里不满意的人,流失率 30%
- 未回应者里满意的人,流失率 62%
也就是说,一个明确告诉你”我不满意”的客户,比一个没填问卷、但事后被判定为”满意”的客户,更不容易走。
这个结论反直觉,但它背后有很硬的逻辑:
填问卷这个动作本身,就是一次关系确认。 愿意花五分钟给你反馈的人,无论打几分,都还在这段关系里。他不满意,说明他还在乎——他有期待,所以才会花时间表达。真正要走的人不会给你打 1 分,他会关掉邮件,什么也不说。
这跟外卖是同一件事:给你打两星的人,至少还打开了这个 App;真正放弃的人,早就卸载了。
所以我的第一个观点是:
“他给几分”远不如”他理不理你”重要。
这两个信号的预测能力不是一个量级。而绝大多数满意度体系,把全部注意力放在了前者,对后者——回收率——只当成一个执行指标,甚至当成客服团队的工作态度指标。
三、这个偏差有个名字,而且它只会往一个方向错
它叫幸存者偏差。经典原型是二战轰炸机:军方统计返航飞机上的弹孔,发现机翼和机身弹孔密集、引擎和驾驶舱几乎没有,直觉是”加固弹孔多的地方”;统计学家 Wald 的结论相反——引擎和驾驶舱中弹的飞机根本没机会返航,所以它们不在样本里。
样本不是随机抽取的,是被结果筛选过的。这就是幸存者偏差的精确定义。
回到客户调研,结构完全一致:
| 轰炸机 | 客户调研 | 外卖评分 |
|---|---|---|
| 样本 = 返航的飞机 | 样本 = 回应问卷的客户 | 样本 = 打了分的用户 |
| 缺失 = 被击落的 | 缺失 = 已流失 / 正在流失的 | 缺失 = 再也不点这家的 |
| 缺失原因 = 中弹位置致命 | 缺失原因 = 关系已结束 | 缺失原因 = 已经失望 |
| 错误结论 = 加固弹孔多处 | 错误结论 = 满意度 92% | 错误结论 = 平台评分都很高 |
你的调研样本,是被”还愿意回应”这个结果筛选过的。 而”愿意回应”恰恰与”会不会流失”高度负相关。
注意这里最麻烦的一点:样本被筛选的机制,和你要预测的目标,是同一个机制。 这是最坏的一种偏差——它不是随机噪声,它是方向性的、系统性的,而且永远往让你安心的方向偏。
这也解释了为什么满意度调研几乎从来不会给出一个糟糕的数字。不是因为产品真的都很好,而是因为它的设计本身就保证了它倾向于报喜。
同样的结构还出现在另外三个地方,而它们通常是公司”用户声音”的全部来源:
- 客服工单:来投诉的人还在用你的产品。真正离开的人不投诉。
- 社群反馈:在群里说话的是活跃用户,他们不代表沉默的大多数。
- 用户访谈:愿意接受一小时访谈的用户,本身就是参与度最高的那批。
三个渠道加在一起,构成一个巨大的、系统性的报喜偏差。
四、还有一层:9 分和 10 分,不是 1 分的差距
就算在回应者内部,把满意度当成一个连续分数看,也有一个常见误判。
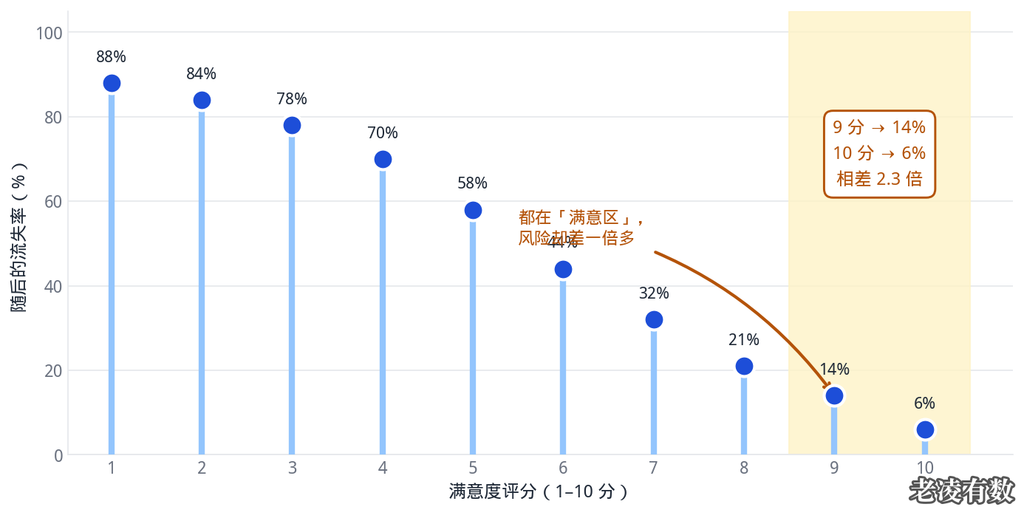
图 5 | 评分与流失率不是线性关系,高分段的差别被严重低估
| 评分 | 流失率 | 与高一分的差距 |
|---|---|---|
| 7 分 | 32% | — |
| 8 分 | 21% | -11 pp |
| 9 分 | 14% | -7 pp |
| 10 分 | 6% | -8 pp |
注意 9 分和 10 分:14% vs 6%,相差 2.3 倍。 而 9 分通常被归入”满意”(≥8 分或 ≥9 分都算满意,取决于你的口径)。
这意味着:一个给 9 分的客户,被你的报表归为”满意客户”,但他的流失风险是给 10 分客户的两倍多。而打满分的人通常只占少数。
更实际的问题是:9 分的人是”满意的流失候选人”。 他没什么可抱怨的,所以他不会投诉,客服系统里没有他,工单里没有他,问卷里他说满意。他只是下个季度不续约了,而且说不出具体原因。
这类客户最难识别,也最难挽回——因为他没有给你任何抓手。
我的建议很具体:在满意度体系里,把 10 分单独作为一个分层。 “打满分的人”和”打 9 分的人”是两个物种,不要合并统计。这一条改动成本几乎为零,但它能救出一批你本来完全看不见的客户。
五、回收率:你手上最便宜的流失预警
讲到这里,可以给一个真正可操作的结论了。
既然”理不理你”比”给几分”重要,那么问卷回收率本身就应该是核心指标,而不是执行指标。
看下面这条时间序列:
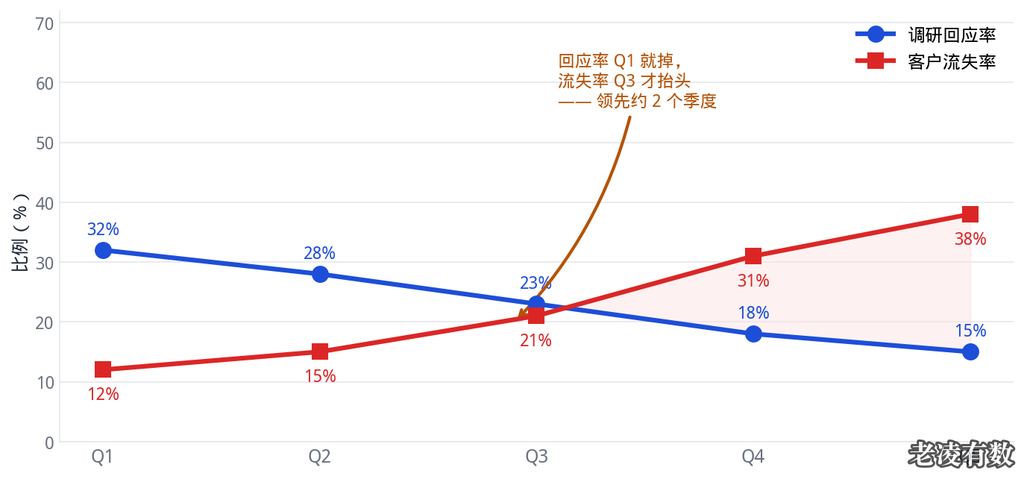
图 6 | 回应率的下降,领先流失率大约两个季度
| 季度 | 调研回应率 | 客户流失率 |
|---|---|---|
| Q1 | 32% | 12% |
| Q2 | 28% | 15% |
| Q3 | 23% | 21% |
| Q4 | 18% | 31% |
| Q5 | 15% | 38% |
回应率从 Q1 就开始掉,而流失率要到 Q3 才明显抬头。领先大约两个季度。
这个结构不难理解:客户决定离开之前,会先经历一段”心理退出”——减少互动、不再反馈、不再参与。这个阶段在行为上首先表现为不回应,然后才表现为不续约。
和外卖一样:他不是某天突然给你打一星然后消失,他是先不打开你的 App,几个月后才彻底忘掉你。
所以:
回收率下降不是”问卷发得不好”,是客户在集体降低参与度。它比你手上任何一个预测模型都更早发出信号,而且成本为零。
我见过太多团队把回收率当成客服的 KPI——回收率低就多发几次、加个红包激励。这是把预警信号当成了执行问题,还亲手把它抹平了。
用红包把回收率拉回 32%,等于把火警铃拆了,然后说”现在安全了”。
正确的做法相反:回收率下降时,第一反应应该是把这批未回应的客户名单拉出来,当成高危名单去排查,而不是想办法让他们填表。你要的是他们的续约,不是他们的问卷。
六、两种口径,两个相反的决策
把前面的数字合起来,看看同一个季度会导出什么。
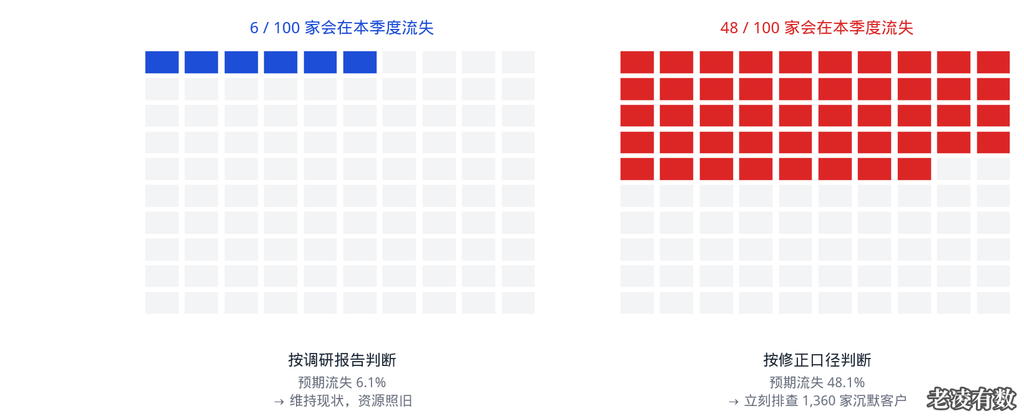
图 7 | 每一格代表 1% 的客户,红色为会在本季度流失的部分
| 按调研报告判断 | 按修正口径判断 | |
|---|---|---|
| 满意率 | 92% | 57.3% |
| 预期季度流失率 | 6.1% | 48.1% |
| 自然推导出的动作 | 维持现状,服务投入不变,把资源投向新客获取 | 立刻排查 1360 家沉默客户,本季度第一优先级 |
这两条路的差距,不是”程度”上的差距,是方向上的差距。前者会让你继续把服务资源投给本来就满意的 589 家客户(他们的流失率只有 4%,本来就不会走);后者会让你去救那 1360 家(其中 962 家会在一个季度内走掉)。
这就是我在这篇文章里唯一想说服你的一件事:
一份错误的乐观报告最贵的地方,不是让你高兴了一下,而是它同时让你错过了唯一还能干预的窗口。
满意度调研不是没用。它有一个非常明确、非常有限的用途:在已经回应的人里做风险排序。它不能用来判断整体健康状况,也不能用来预测流失。用它做这两件事,就是让它承担它结构上无法承担的任务。
七、可以立刻改的 5 件事
不需要换系统,不需要立项,这五件事这周就能做:
1. 在所有满意度数字的旁边,强制显示分母和回收率。
把”满意度 92%”改成”满意度 92%(640/2000,回收率 32%)”。就加这一行,误导性下降一大半。如果报表模板不让加,就在汇报时第一页口述一遍。
2. 把”未回应名单”当成独立的高危名单单独运营。
不要试图提高回收率,直接把名单拉出来交给客户成功团队。这批人的价值远高于再发一轮问卷。
3. 给 9 分和 10 分做分层。
把”十分满意”单独统计。9 分是”满意但有保留”,10 分才是”真的没问题”。合并统计会淹没最重要的那条分界线。
4. 建立一个不依赖自陈态度的行为指标。
登录频次、核心功能使用深度、最近一次有效互动距今天数——这些不需要客户开口,也就不存在响应偏差。它们的预测能力通常高于任何问卷。行为数据不会骗你,因为客户不知道你在看它。
5. 对已流失客户做回溯访谈,并且只看这一批。
已经流失的人不会出现在任何一份在用的调研里,但他们掌握着全部答案。他们的意见缺失,正是你现有体系最大的盲区。这件事做一次,比把问卷回收率提高 20 个百分点有用得多。
最后一句
如果你的公司也有一份”92% 好评”的报告,我不建议你立刻怀疑它的数据质量——数据大概率是准确的。
我建议你问的是这三个问题:
- 这个百分比的分母是多少?(640 还是 2000)
- 没进入分母的那批人,后来怎么样了?(有没有人追踪过)
- 如果这个数字是错的,我们会在多久之后才发现?(发现的时候还来得及吗)
第三个问题最重要。因为这类偏差的共同特点不是”数字错了”,而是它错的方向永远是让你晚一点知道坏消息。
就像外卖 App 上那些 4.5 分的店——它们不是骗你,它们只是把不再点单的人的意见,安静地删掉了。
拍板之前,先过这 10 关
我做了一份《数据决策 10 问清单》。10 个问题,帮你在为一个数据结论拍板之前,先确认它能不能信——尤其是当这个结论要花掉真金白银的时候。
👉 访问 archcode.cn 免费领取 | 公众号后台回复「10问」
如果你手上正有一份报告拿不准,也可以直接找我:发过来,我出 3 页诊断意见。