适合谁:运营、初级分析师。会用 Excel,能看懂简单 SQL,但要取个稍微复杂点的数就得找人排期。 读完能拿到:一套可直接复制的提示词模板 + 5 段完整可执行代码 + 一份发布前必看的自检清单。
一个运营想看”上个月新客的二次购买率”,提了需求,数据同学回了一句:”排期到下下周。”
看起来只是一句普通的回复。但把它算成钱:这个运营月薪按 15k 算,一天成本约 700 元。等 5 个工作日,就是 3500 元——为一个可能只用来调整一次投放的数字。
更贵的成本不在工资,在时机。等数据出来的那天,投放早调完了,活动早结束了,当初那个问题已经被下一个问题盖过去了。拿到数字的人会说一句”哦”,然后它静静躺在某个文件夹里。
真实情况是:这个查询本身并不难,难的是”把人话翻译成 SQL”这一层。而这恰好是眼下最容易被 AI 替掉的一层。
这篇文章给你一套可以直接复制的提示词模板,外加 5 段完整可执行的案例——从”我想要上个月买过 A 又买了 B 的人”到能跑的查询,中间只差一段提示词。
先说结论
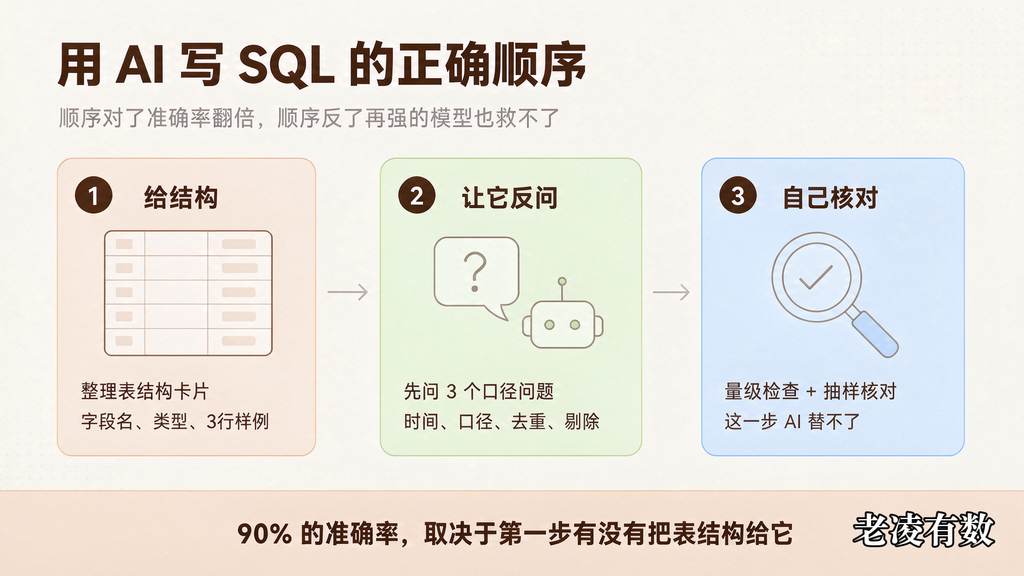
AI 写 SQL 准不准,90% 取决于你有没有把表结构给它。
很多人用 AI 写 SQL 的失败姿势是这样的:把需求原封不动丢过去——”帮我写个 SQL,统计上周各渠道的新增用户数”。然后拿到一段看起来很专业、跑起来必错的 SQL。
原因很简单:模型不知道你的表长什么样。它只能凭经验猜字段名——猜 user_id 还是 uid?create_time 还是 created_at?猜错一个字,整段就废了。
而表结构这个东西,你自己是有的。这就是全部的关键。
整个流程只有三步,顺序不能反:
原来怎么办:两条路都很难受
路线一:找数据同学排期。 提需求 → 等排期(通常 1–2 天)→ 对方反问你口径 → 你再去问业务确认 → 来回两三轮 → 终于拿到数。等拿到的时候,会都开完了。
路线二:自己硬写。 憋半小时写出来一句,一跑报错;对着报错改,改到最后能跑通了,但你不知道它对不对——这是最危险的状态。跑得出来的错 SQL,比报错的 SQL 危害大得多,因为它会变成一份看起来有数据支撑的错误结论。
AI 的价值不是替你写,是把”憋”这个环节压掉,让你把精力放在核对口径上。
第一步:准备表结构(这是唯一需要你花时间的部分)
不需要多专业,三种方式任选,能拿到就行:
-- 方式一:直接问数据库(MySQL / Hive 通用) SHOW CREATE TABLE dwd_order_detail; -- 方式二:查 information_schema,批量拿字段名和类型 SELECT column_name, data_type, column_comment FROM information_schema.columns WHERE table_name = 'dwd_order_detail' ORDER BY ordinal_position; -- 方式三:自己整理(最推荐,见下方卡片)
最小可用的表结构卡片(照这个格式写,一行一个字段):
表名:dwd_order_detail(订单明细表,分区字段 dt)
字段:
order_id string 订单ID(唯一)
user_id string 用户ID
channel string 渠道:ios / android / h5 / mini_program
pay_amount decimal 实付金额(元),退款订单也为正数
order_status int 订单状态:1待支付 2已支付 3已退款 4已取消
create_time datetime 下单时间(UTC+8)
dt string 分区日期,格式 yyyy-MM-dd
样例数据:
order_id user_id channel pay_amount order_status create_time dt
A001 U1001 ios 99.00 2 2026-09-01 10:23:11 2026-09-01
A002 U1002 android 0.00 4 2026-09-01 11:05:02 2026-09-01
A003 U1001 ios 49.00 3 2026-09-02 09:14:38 2026-09-02
这张卡片做一次,能反复用一年。 建议把你常用的三五张表整理成一个文档存着,以后每次取数直接复制粘贴。
第二步:先让 AI 反问你,别急着让它写
这是最容易被跳过、但最有用的一步。
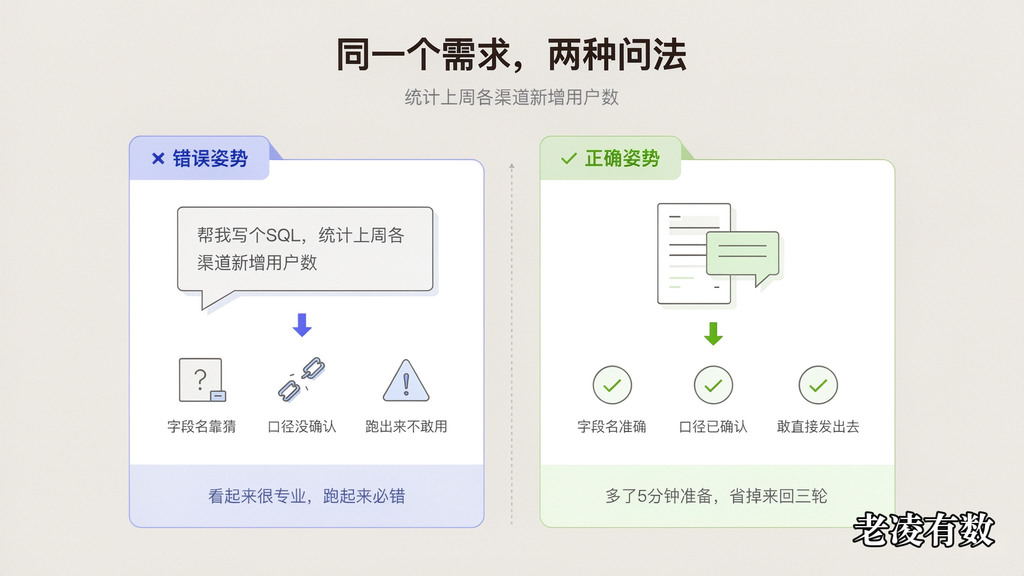
直接让它写,它会替你做假设。而它做的假设,通常是行业通用口径,不是你们团队的口径。
所以在提示词里加一句:
在写 SQL 之前,先问我不超过 3 个问题,用于确认会影响结果的关键口径。
在我回答之前,不要写 SQL。
它通常会问这几类问题——而这几个问题,恰好就是数据同学会反问你的那些:
- 时间范围:自然周还是最近 7 天?按下单时间还是支付时间?
- 口径定义:”新增用户”指首次下单,还是首次注册?”活跃”指有任意行为还是有核心行为?
- 去重粒度:按用户去重还是按订单去重?
- 异常剔除:要不要剔除退款单、测试账号、内部员工单?
这四个问题想清楚了,SQL 就对了一半。 反过来,如果你答不上来,说明这个需求本身还没想清楚——这时候去找业务确认,比写 SQL 重要得多。
第三步:让 AI 写(提示词模板)
下面这段可以直接复制,把括号里的内容换成你自己的。
你是资深数据分析师,熟悉 Hive / MySQL / PostgreSQL 语法差异。
我会给你表结构和需求,请你写 SQL。
【表结构】
(粘贴上一步准备好的表结构卡片)
【我的需求】
统计 2026-09-01 至 2026-09-07 期间,各渠道的支付订单数和支付金额,
只统计已支付订单,剔除退款和取消,按渠道分组。
【已确认的口径】
- 时间按下单时间 create_time 算
- 订单数按 order_id 去重
- 金额用 pay_amount 求和,单位为元
- 剔除 order_status = 3(已退款)和 4(已取消)
- 剔除 pay_amount = 0 的订单
【约束】
1. 只能使用上面表结构中出现的字段,不许编造表名和字段名
2. 必须带上分区字段 dt 的过滤条件,避免全表扫描
3. 日期范围用 >= 和 < 写,不要用 BETWEEN
4. 字段和表名保持我的命名,不要重命名
5. 如果我的需求有歧义或缺少必要信息,直接指出,不要自行假设
【输出格式】
1. SQL(代码块内,可直接执行)
2. 逐段解释:每一段在做什么,用大白话
3. 口径说明:这段 SQL 最终统计的是什么,一句话讲清
4. 风险提示:这条 SQL 可能在哪些情况下算错,列出 2-3 条
为什么要求”逐段解释”和”风险提示”?
不是为了让你学 SQL,是为了让你能核对。你读不懂的 SQL,就不该发出去。
AI 会返回什么(真实输出示例)
SELECT
    channel,
    COUNT(DISTINCT order_id)                AS pay_order_cnt,   -- 支付订单数
    ROUND(SUM(pay_amount), 2)               AS pay_amount_sum   -- 支付金额(元)
FROM dwd_order_detail
WHERE dt >= '2026-09-01'
  AND dt <  '2026-09-08'                    -- 左闭右开,覆盖 09-01 ~ 09-07 共 7 天
  AND create_time >= '2026-09-01 00:00:00'
  AND create_time <  '2026-09-08 00:00:00'
  AND order_status = 2                      -- 只保留已支付
  AND pay_amount > 0                        -- 剔除 0 元单
GROUP BY channel
ORDER BY pay_amount_sum DESC;
逐段解释(大白话版):
| 片段 | 在干什么 |
|---|---|
dt >= '09-01' AND dt < '09-08' | 先按分区裁剪,只扫这 7 天的分区,避免全表扫描 |
create_time >= ... AND < ... | 再按下单时间精确卡边界,左闭右开 |
order_status = 2 | 只要已支付;退款(3)、取消(4)被排除 |
COUNT(DISTINCT order_id) | 订单数去重计数;数”人”时才用 DISTINCT user_id |
ROUND(SUM(pay_amount), 2) | 金额求和保留两位小数 |
口径说明:这条 SQL 统计的是 2026-09-01 00:00:00 至 2026-09-07 23:59:59 期间,按下单时间归口、状态为已支付且金额大于 0 的订单,按渠道分组的订单数与实付金额。
第四步:跑之前,让它自己检查一遍
拿到 SQL 之后,别急着执行,追加一句:
请以一个挑剔的数据 reviewer 的视角检查这段 SQL:
1. JOIN 会不会导致行数膨胀?有没有该用子查询先聚合的地方?
2. 有没有 NULL 没处理?count 和 count(distinct) 用对了吗?
3. 日期边界有没有问题?时区对不对?
4. 有没有全表扫描风险?分区字段加上了吗?
5. 如果数据量很大,应该怎么改写?
指出问题并给出修改后的 SQL,不要客气。
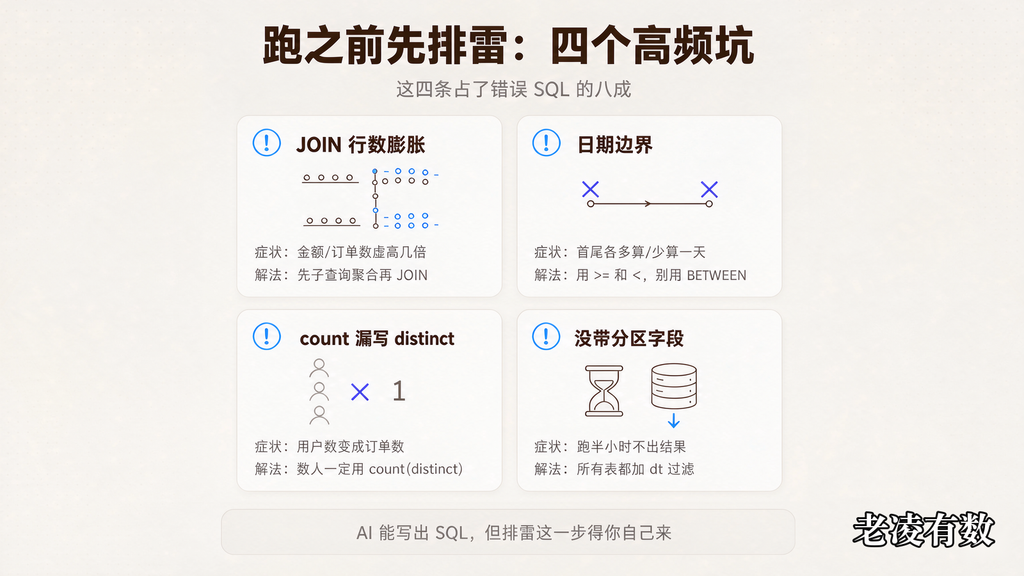
四个高频坑,逐个给代码
坑 1:JOIN 行数膨胀 —— 症状是金额虚高几倍
-- ❌ 错误:明细对明细直接 JOIN,一个订单被放大成 N 行,金额翻倍 SELECT o.channel, SUM(o.pay_amount) AS amount FROM dwd_order_detail o LEFT JOIN dwd_order_item i ON o.order_id = i.order_id -- 一个订单多个商品 WHERE o.dt >= '2026-09-01' AND o.dt < '2026-09-08' AND o.order_status = 2 GROUP BY o.channel; -- ✅ 正确:先在子查询里把明细聚合到订单粒度,再 JOIN WITH order_base AS ( SELECT order_id, channel, pay_amount FROM dwd_order_detail WHERE dt >= '2026-09-01' AND dt < '2026-09-08' AND order_status = 2 ), item_agg AS ( SELECT order_id, COUNT(1) AS item_cnt -- 子表先聚合到订单粒度 FROM dwd_order_item WHERE dt >= '2026-09-01' AND dt < '2026-09-08' GROUP BY order_id ) SELECT o.channel, COUNT(DISTINCT o.order_id) AS pay_order_cnt, ROUND(SUM(o.pay_amount), 2) AS amount, -- 金额不再被放大 SUM(COALESCE(t.item_cnt, 0)) AS item_cnt FROM order_base o LEFT JOIN item_agg t ON o.order_id = t.order_id GROUP BY o.channel;
坑 2:日期边界 —— 症状是首尾各多算/少算一天
-- ❌ 错误:BETWEEN 是闭区间,09-07 当天 23:59:59 之后的数据会被算进来吗? -- 更麻烦的是 create_time 带时分秒时,BETWEEN '09-01' AND '09-07' 实际只到 09-07 00:00:00 WHERE create_time BETWEEN '2026-09-01' AND '2026-09-07' -- ✅ 正确:左闭右开,永远不踩边界 WHERE create_time >= '2026-09-01 00:00:00' AND create_time < '2026-09-08 00:00:00'
坑 3:count 漏写 distinct —— 症状是”用户数”变成了”订单数”
-- 数订单:用 COUNT(order_id),订单ID本身唯一时可不加 DISTINCT COUNT(order_id) AS order_cnt -- 数人:必须加 DISTINCT,否则一个用户下 5 单就被算成 5 个人 COUNT(DISTINCT user_id) AS user_cnt
坑 4:没带分区字段 —— 症状是跑半小时不出结果,被 DBA 找上门
-- ❌ 全表扫描 SELECT COUNT(1) FROM dwd_order_detail WHERE create_time >= '2026-09-01'; -- ✅ 带分区裁剪(dt 是分区字段,必须出现在 WHERE 里) SELECT COUNT(1) FROM dwd_order_detail WHERE dt >= '2026-09-01' AND dt < '2026-09-08' AND create_time >= '2026-09-01 00:00:00' AND create_time < '2026-09-08 00:00:00';
一个通用的”先试跑”习惯
-- 正式跑全量之前,先 LIMIT 看一眼数据结构和量级
SELECT channel, COUNT(DISTINCT order_id) AS cnt
FROM dwd_order_detail
WHERE dt >= '2026-09-01' AND dt < '2026-09-08'
  AND order_status = 2
GROUP BY channel
LIMIT 100;
必须人工把关的清单
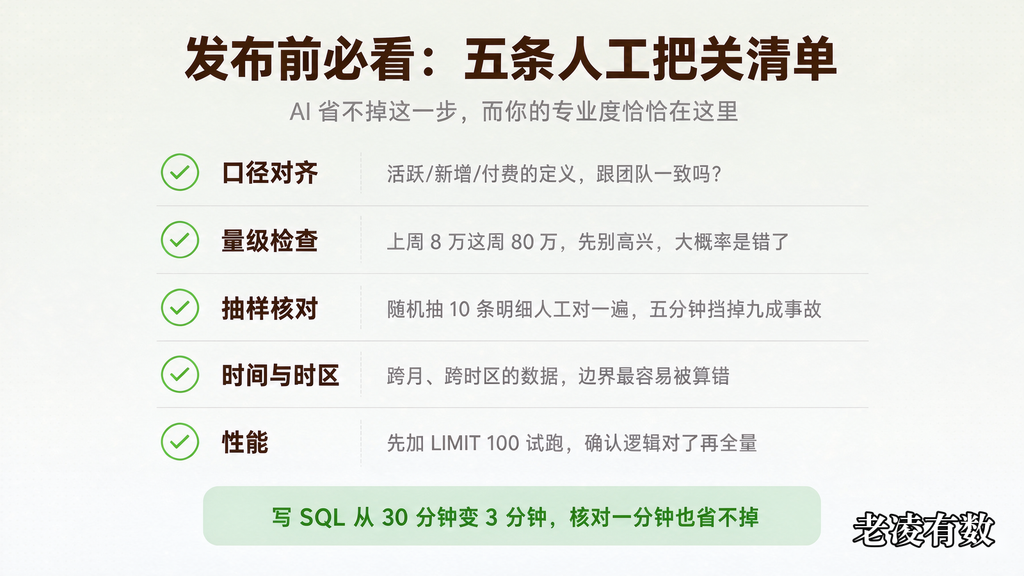
这五条是底线,AI 替代不了,也是你作为分析者的价值所在。
- 口径对齐:活跃/新增/付费的定义,跟你们团队一致吗?跟上次报的数能对上吗?
- 量级检查:先跑
count(*)看总量。上周 8 万,这周 80 万——先别高兴,大概率是错了。 - 抽样核对:随机抽 10 条明细,人工对一遍。这一步五分钟,能挡掉九成事故。
- 时间与时区:跨月、跨时区的数据,边界最容易被算错。
- 性能:大数据量先加
LIMIT 100试跑,确认逻辑对了再全量。
一句实话:AI 可以让”写 SQL”从 30 分钟变成 3 分钟,但它一分钟也省不掉”核对”的时间。 而你真正的专业度,恰恰体现在核对这一步——模型再准,业务不用就是零;SQL 再快,结论错了就是负数。
举一反三:同一套方法,换个场景照样跑
不会写 pandas?把 dtypes 和 head() 贴给它:
import pandas as pd
df = pd.read_csv('order.csv')
# 这两行输出,就是给 AI 的"表结构卡片"
print(df.dtypes)
print(df.head(3).to_string())
本文提示词已在 Hive / MySQL / PostgreSQL 场景下验证。不同数仓语法有差异,执行前请根据实际环境调整
拍板之前,先过这 10 关
我做了一份《数据决策 10 问清单》。10 个问题,帮你在为一个数据结论拍板之前,先确认它能不能信——尤其是当这个结论要花掉真金白银的时候。
👉 访问 archcode.cn 免费领取 | 公众号后台回复「10问」
如果你手上正有一份报告拿不准,也可以直接找我:发过来,我出 3 页诊断意见。