栏目:建模实验 | 标签:AUC、线上线下一致性、特征穿越、模型上线、机器学习工程
关于本文的说明
文中 AUC 0.85 与五个断点是用于讲清机制的示意设定,不指向任何具体项目。分布漂移图为模拟数据。五个断点、排查方法与六条自检是通用的,可直接套用。
先看一个生活里的版本
有人在驾校考了满分。科目一 100 分,倒车入库一把进,侧方停车零失误。
然后他第一次上路——熄火三次,并线忘了打灯,遇到加塞完全不知道怎么办。
他考了满分,也确实不会开车。
问题不在他的驾驶技术,在于:考试考的那些项目,和真实上路要做的事,中间隔着好几步。 驾校的场地是固定的、没有别的车、没有行人、没有人按喇叭。而他学的所有动作,都是在这套被简化过的环境里练出来的。
模型从”离线评估”到”线上生效”,中间也是这样——隔着五步,每一步都有可能在静默中失效。
场景:AUC 0.85 与”什么都没发生”
离线评估 AUC 0.85,这个数字在多数场景下算是相当不错的。
模型上线,跑 A/B 测试。两周后看关键指标——几乎没动。
然后常见的对话是:
“模型不够准吧?” “要不要换个更复杂的算法?” “再加点特征试试?”
我的经验是:这类落差几乎都不是模型问题。
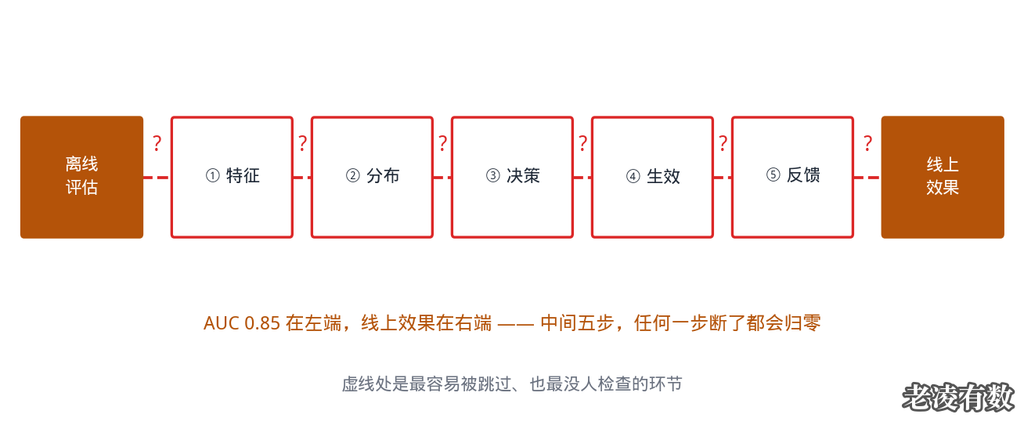
图 1 | AUC 0.85 在左端,线上效果在右端,中间五步任何一步断了都会归零
离线评估和线上决策之间,隔了五个没人检查的环节。 而最容易掉链子的,往往是最不起眼的那一环。
一、断点 ①:特征穿越
这是头号杀手,也是最容易发生的。
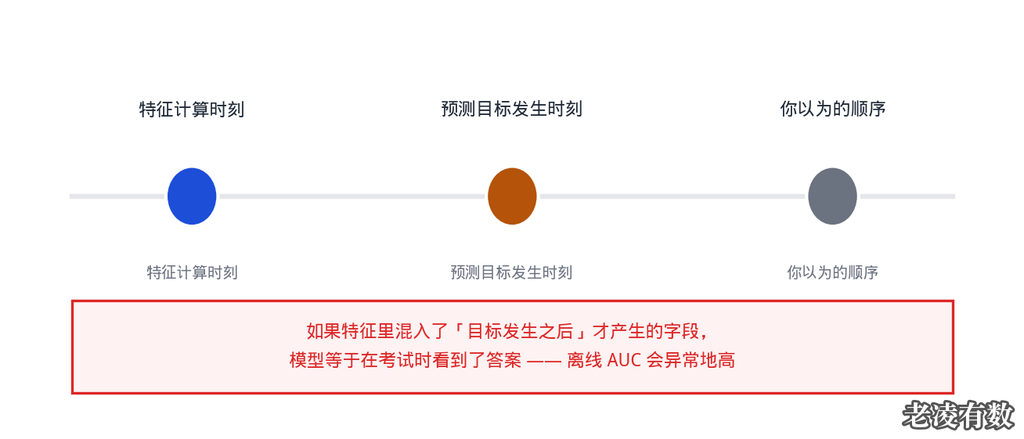
图 2 | 特征里混入了”目标发生之后”才产生的字段
特征穿越(Data Leakage)的意思是:你的特征里,混进了一些只有在目标发生之后才会产生的信息。
举个具体的例子。你要预测”用户会不会流失”。
你在特征里用了”最近一次登录距今天数”——这没问题。
但如果你不小心用了”账号状态”这个字段,而”账号状态”是在用户已经注销之后才被更新为”已注销”的——那模型等于在考试时看到了答案。
它会学到一个完美但无用的规律:”账号状态 = 已注销 → 会流失”。
离线 AUC 会异常地高,可能 0.95 以上。而上线之后,这个字段在预测时刻永远是”正常”,模型什么也预测不出来。
怎么查:
- 列出所有特征,逐个标注它的产生时刻。
- 任何一个产生时刻晚于(或等于)预测目标发生时刻的特征,全部剔除。
- 特别小心聚合类特征——”近 7 天的行为统计”这类特征最容易混入未来信息,因为窗口的边界常常没对齐。
补一句:AUC 高得反常,本身就是特征穿越的信号。 如果一个模型的离线 AUC 高到你觉得”好得不像真的”,那它大概率不是真的。
二、断点 ②:训练与线上的分布漂移
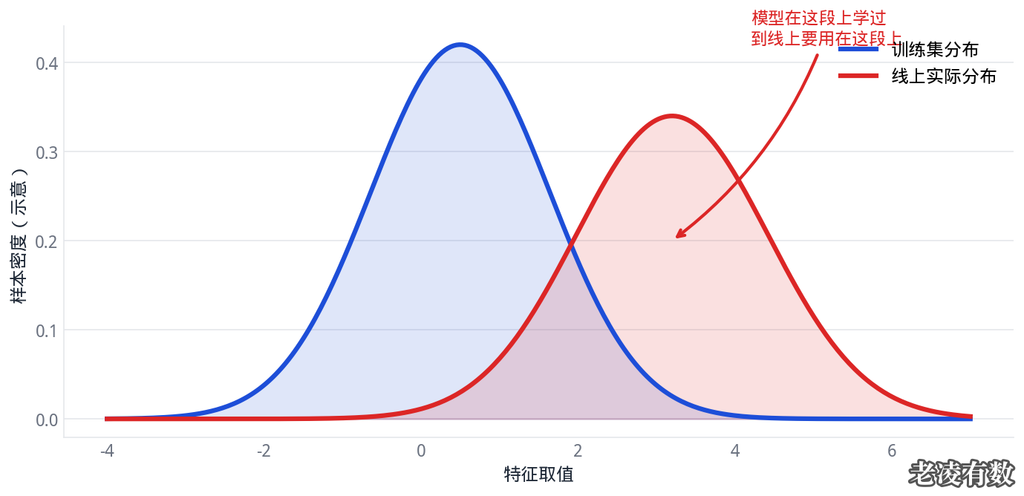
图 3 | 模型在蓝色区域上学过,到线上要用在红色区域上
模型在训练集上学到的规律,只在训练集的分布范围内成立。
而上线的环境通常在变化——用户结构变了、改版了、投放渠道换了、季节变了。
怎么查:
把关键特征在”训练集”和”上线后最近两周”的分布画出来对比。就两张密度图,十分钟能做完。
如果发现明显偏移,那 AUC 再高也没有意义——你是在用旧的分布,预测新的样本。
这里有个容易踩的坑:训练数据的时间范围。如果你的训练数据全部来自去年,而线上是今年,那分布漂移几乎是必然的,而且不会有任何报错。
三、断点 ③:打分与决策脱节
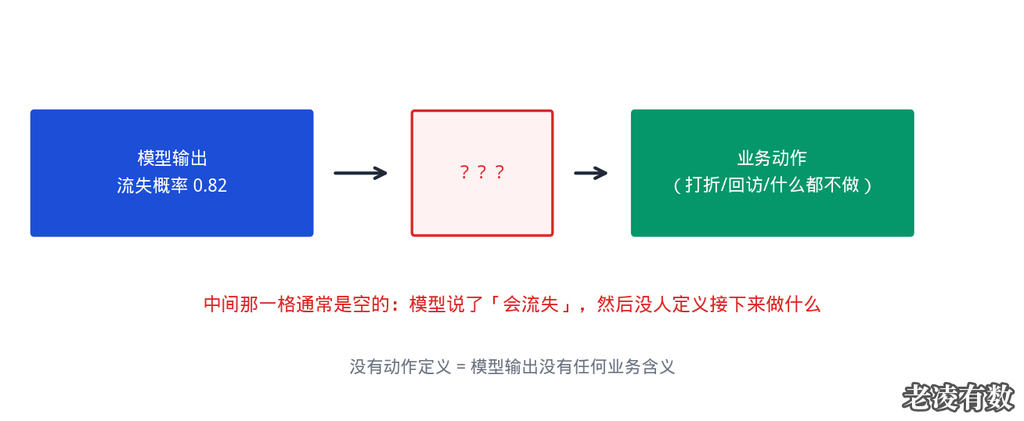
图 4 | 中间那一格通常是空的
这是我在实际项目里见得最多的一个,也是最不像”技术问题”的一个。
模型输出:
“这个用户流失概率 0.82”
然后呢?
然后没有然后了。 没有人定义过”0.82 的时候该做什么”。
- 该给他打折吗?打多少?
- 该让客服回访吗?什么时候?
- 还是什么都不做?
如果这些没有定义,那么模型输出就没有任何业务含义。它只是一个数字,被写进一张表里,没有人看。
怎么查:
问一句:“模型给一个用户打了 0.85 分,接下来谁、在什么时间、做什么动作?”
如果这个问题没有答案,那模型一定不会有线上效果——不管它的 AUC 是多少。
这也是为什么我一直认为:模型项目的需求文档里,最该写清楚的那一节不是”用什么算法”,而是”分数出来之后做什么”。
四、断点 ④:生效时延
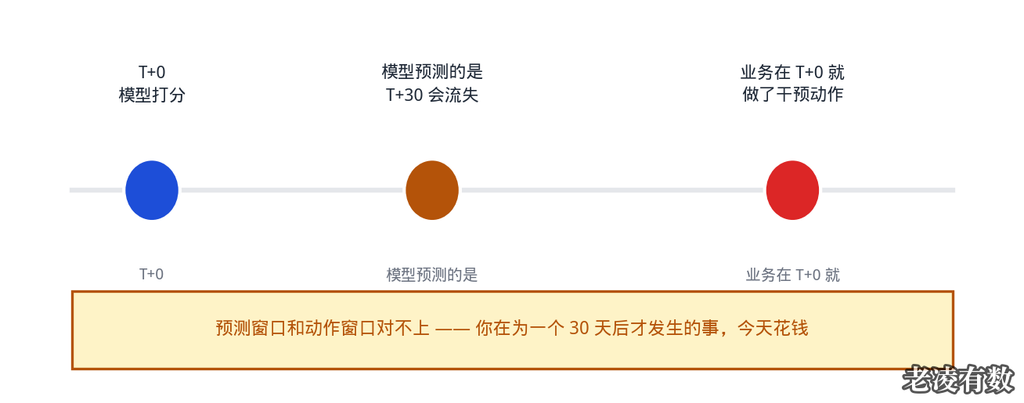
图 5 | 预测窗口和动作窗口对不上
这个断点很隐蔽,因为它通常涉及两个团队。
典型情况:
- 模型预测的是“未来 30 天会流失”
- 业务在模型给出高分的当天,就给用户发了一张优惠券
于是:你在为一件 30 天后才可能发生的事,今天花钱。
结果看起来是”模型没用”——因为那批人本来 30 天内也不一定会流失,你提前干预了,看不出增量。
怎么查:
确认两件事并对齐:
- 模型的预测窗口(T+30?T+7?)
- 干预动作的作用窗口(今天发券,影响的是今天的行为)
这两个窗口必须匹配。如果不匹配,要么调整模型的预测周期,要么调整干预的时机。
五、断点 ⑤:反馈回路缺失
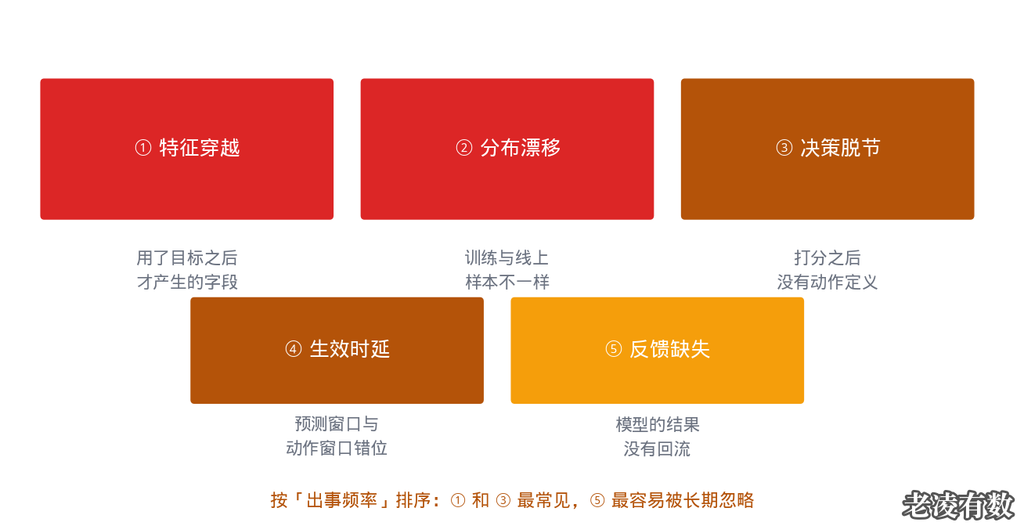
图 6 | 按出事频率排序,⑤ 最容易被长期忽略
最后一个,也是最容易被长期忽略的:
模型产生的结果,有没有回流成新的训练数据?
具体来说:
- 模型说”会流失”的那些人,后来真的流失了吗?
- 你干预过的那些人,干预有效吗?
- 这些结果有没有被记录下来,用来更新模型?
如果没有,那么模型从上线那天起就在单向衰减——环境在变,模型不变,效果只会越来越差。
而且这件事不会立刻显现。 第一个月效果还行,第三个月开始掉,第六个月已经没什么用了。等到你发现的时候,你无法判断是”模型老化”还是”当初就没效”。
怎么查:
问一句:“模型上线之后,我们积累了多少条’预测 + 实际结果’的配对数据?”
如果答案是零,说明反馈回路是断的。
顺带说一个检查技巧:做一次”反向上线测试”
排查五个断点需要时间。有一个更快的方法,能一次性判断”到底是不是模型的问题”:
随机打分对照组。
做法很简单:在 A/B 测试里加一组,这一组的分数是随机数(不来自模型),但业务动作照常执行。
然后看三组的关键指标:
- A 组:无干预(对照组)
- B 组:模型打分 + 干预
- C 组:随机打分 + 干预
结果有四种可能:
| 观察结果 | 说明 |
|---|---|
| B 明显好于 A,C 和 A 差不多 | ✅ 模型有效,且干预有效 |
| B 和 C 差不多,都好于 A | ⚠️ 干预本身有用,模型没贡献——换个打分方式也一样 |
| B 和 C 差不多,都和 A 差不多 | ❌ 干预本身没用,模型再准也没意义 |
| B 比 A 还差 | ❌ 模型在帮倒忙,通常说明打分与目标反了 |
第二种情况是我见过最多的:模型上线”有效果”,但其实效果全部来自”你终于对这批人做了点什么”,跟打分准不准没关系。
而这时候,一个简单的规则(比如”30 天没登录就回访”)能达到几乎相同的效果,成本却低得多。
这个测试的价值在于:它把”模型有没有用”拆成了”干预有没有用”和”打分有没有用”两件事。 而这两件事的解法完全不同。
六、模型上线之前过这 6 关
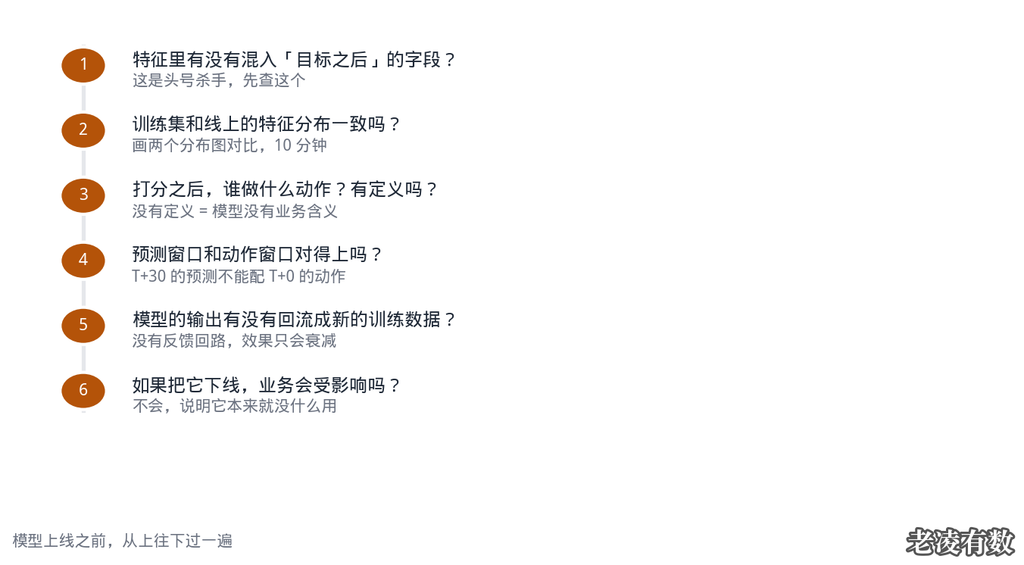
图 7 | 模型上线之前,从上往下过一遍
- 特征里有没有混入”目标之后”的字段?(这是头号杀手,先查这个)
- 训练集和线上的特征分布一致吗?(画两个分布图对比,10 分钟)
- 打分之后,谁做什么动作?有定义吗?(没有定义 = 模型没有业务含义)
- 预测窗口和动作窗口对得上吗?(T+30 的预测不能配 T+0 的动作)
- 模型的输出有没有回流成新的训练数据?(没有反馈回路,效果只会衰减)
- 如果把它下线,业务会受影响吗?(不会,说明它本来就没什么用)
第 6 条是个很实用的检验:找一个业务方,问他”如果这个模型明天停了,你们会有影响吗”。
如果他说”好像没什么影响”——那这个模型的线上效果早就归零了,只是没人去确认。
这个测试比任何指标都直接。
顺带说一句:写一份”模型说明书”
最后给一个能在长期省下大量时间的做法。
模型项目最常见的问题是:上线半年后,没人记得当初的约定。
谁负责看效果?多久复查一次?预测窗口是多少?当时为什么排除那几个特征?这些问题的答案,通常只存在于当时那个人的脑子里——而他已经去做别的项目了。
一份”模型说明书”能解决大部分这类问题。 它不需要很长,但必须包含五项:
① 预测目标与预测窗口(T+N?)
② 打分之后由谁执行什么动作(这是最容易缺的一条)
③ 训练数据的时间范围与主要特征清单
④ 已知的不适用场景(哪些人群/时段不要用)
⑤ 复查周期与负责人
第 ② 条和第 ④ 条最常被漏掉,也最常在半年后引发问题。
尤其是第 ④ 条:每个模型都有它不适用的场景,而这些场景在上线时通常没人写下来。等到有人在不适用的场景里用了它、得出一个荒谬的结论、然后质疑”模型是不是坏了”——这时候你要花的时间,远超当初写下这一段的十分钟。
最后一句
回到驾校那个例子。
考满分的人不是不会开车,他是在没有其他车、没有行人、没有人按喇叭的环境里学会了所有的动作。他的每一个动作都是对的——在驾校的场地里。
模型的 AUC 0.85 也是真的——在测试集的分布里。
而从测试集到真实业务,中间隔着特征、分布、决策、时机、反馈这五步。这五步没有任何一步会出现在评估报告里,但任何一步断了,最终效果都是零。
离线指标衡量的是”模型在数据集上有多好”。 线上效果衡量的是”这套系统有没有改变任何一件事”。
这两个问题之间,隔着的是工程和业务定义,不是算法。
所以下次遇到”AUC 很高但没效果”,先别急着换模型——按那六条,从上往下查一遍。
十分钟能查完,而且大概率能找到问题。
如果你手上正跑着一个模型,用上面第 6 节那 6 条对照一遍,10 分钟能做完。做完发现对不上,可以找我聊聊。
拍板之前,先过这 10 关
我做了一份《数据决策 10 问清单》。10 个问题,帮你在为一个数据结论拍板之前,先确认它能不能信——尤其是当这个结论要花掉真金白银的时候。
👉 访问 archcode.cn 免费领取 | 公众号后台回复「10问」
如果你手上正有一份报告拿不准,也可以直接找我:发过来,我出 3 页诊断意见。