基础比率谬误:流失率仅 26.54%,全猜”不流失”的基线就有 73.46%
数据:IBM / UCI Telco Customer Churn 电信客户流失(7,043 条,公开数据)(公开数据集,可自行下载复现)
先看一个场景
算法同学汇报:“我们的流失预测模型,准确率 65%。”
听上去还行。但先别急着判断——问一句:这个业务里,什么都不做能有多少准确率?
答案是 73.46%。
用真实数据算一遍
数据:7,043 名电信客户,其中流失 1,869 人,流失率 26.54%。
最简单的策略:所有人都预测”不流失”。
猜"不流失"的人里有 73.46% 真的没流失
→ 准确率 73.46%
这就是及格线。任何模型达不到它,还不如不做。
现在看那个”月付就预测流失”的规则:
| 指标 | 数值 |
|---|---|
| 准确率 | 65.44% |
| 精确率 | 42.7% |
| 召回率 | 88.6% |
| F1 | 57.6% |
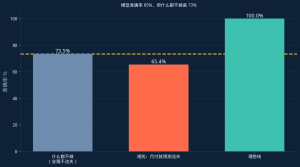
准确率 65.44%,低于基线 73.46%。 这个规则比”什么都不做”还差。
但换个指标,它又不差
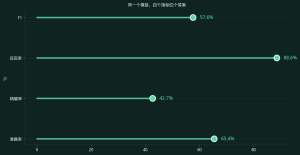
同一个模型,四个指标给出四个答案:
-
准确率 65.44% → 低于基线,看着很差
-
召回率 88.6% → 抓到了 88.6% 的真实流失,看着很好
-
精确率 42.7% → 报警的人里只有 42.7% 真流失,一半是误报
哪个是对的?都对,取决于你要干什么。
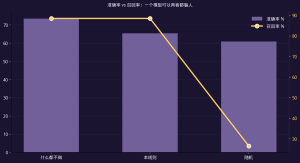
拆开看那 7,043 个人
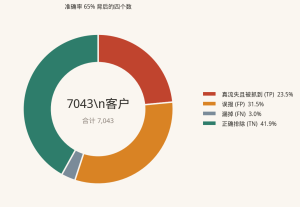
真流失且被抓到  1655 人
误报            2220 人   ← 白忙
漏掉            214 人
正确排除        2954 人
误报 2220 人,比抓对的 1655 人还多。 如果每打一个挽留电话有成本,这个模型会浪费一半人力。
但另一方面,它抓到了 88.6% 的流失——如果流失代价很高,这个召回率是有价值的。
评估前,先算一条基线
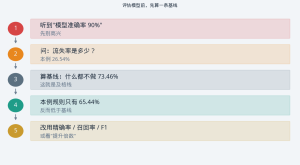
-
算基础比率:流失率多少?本例 26.54%
-
算基线准确率:全猜多数类 = 73.46%。模型必须超过它
-
看精确率:报警的人里多少是真的?决定人力成本
-
看召回率:真实的流失抓到多少?决定漏掉的损失
-
算提升倍数:42.7% ÷ 26.54% = 1.61 倍(比瞎猜准多少)
第 5 条最能说明价值——本例精确率 42.7%,是瞎猜(26.54%)的 1.61 倍。这个数比”准确率 65%”有意义得多。
什么时候用哪个指标
| 场景 | 看什么 | 原因 |
|---|---|---|
| 流失预测、疾病筛查 | 召回率 | 漏掉代价高 |
| 垃圾邮件、风控拦截 | 精确率 | 误报代价高 |
| 两类代价差不多 | F1 | 平衡 |
| 类别极度不平衡 | 别看准确率 | 会被基础比率骗 |
规律:正例占比越小,准确率越没用。 流失率 26% 时准确率已经会骗人;如果是千分之一的欺诈检测,99.9% 准确率的模型可能一个都没抓到。
附:可运行代码
数据集:IBM / UCI Telco Customer Churn 电信客户流失(7,043 条,公开数据)
import pandas as pd
df['churn'] = (df['Churn'] == 'Yes').astype(int)
base = df['churn'].mean()
print('流失率 %.2f%%' % (100 * base))
print('什么都不做(全猜不流失)准确率 %.2f%%' % (100 * (1 - base)))
# 一个简单规则:月付就预测流失
pred = (df['Contract'] == 'Month-to-month').astype(int)
acc = (pred == df['churn']).mean()
tp = ((pred == 1) & (df['churn'] == 1)).sum()
fp = ((pred == 1) & (df['churn'] == 0)).sum()
fn = ((pred == 0) & (df['churn'] == 1)).sum()
prec, rec = tp / (tp + fp), tp / (tp + fn)
print('准确率 %.2f%% 精确率 %.1f%% 召回率 %.1f%%'
% (100*acc, 100*prec, 100*rec))
print('提升倍数 %.2f 倍' % (prec / base))跑一遍你会看到:准确率 65.44% < 基线 73.46%,但精确率是瞎猜的 1.61 倍。
如果你也在做类似的东西,欢迎交流,我这边有完整实现,可以发你参考。
