右偏分布:均值 8.1 / 中位数 0.0 / 偏度 3.78,均值型指标在什么时候会失效
先看一个场景
运营同学拿到一份数据:某服务平均响应时间 8 分钟。他据此对客承诺”我们平均 8 分钟响应”。
结果投诉来了——三成客户说等了不止 8 分钟。
他没算错。8 分钟确实是平均值。问题出在:平均值不等于”大多数人的体验”。
用两万条真实航班记录看看
数据:20,000 条航班延误记录(美国运输统计局 BTS,公开数据)。
均值      8.1 分钟
中位数    0.0 分钟
标准差    25.38 分钟
偏度      3.78
均值和中位数差了整整 8.1 分钟。
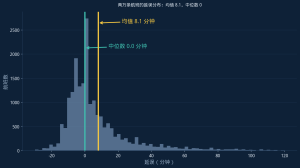
这张图把两万条航班的延误画成了分布。橙色线是均值,绿色线是中位数——中位数在 0,也就是有一半航班根本没延误。
可均值被拉到了 8.1。谁干的?看这张构成图:
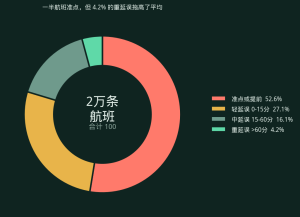
4.2% 的重延误航班(超过 1 小时),把平均值整个拽了上去。它们人少,但每一条的分量都很重。
为什么”按均值承诺”一定会翻车
关键在这里:
| 如果按这个数承诺 | 会有多少航班做不到 |
|---|---|
| 中位数 0.0 分钟 | 47.4% 超标 |
| 均值 8.1 分钟 | 30.2% 超标 |
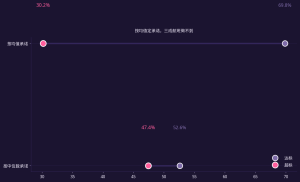
按均值承诺,仍有 30.2% 的航班超了。 因为均值右边(比均值慢的)虽然人少,但拖得很长;左边(快的)人多但挤在一起。
这就是右偏分布:少数极端值把均值拉高,中位数岿然不动。
日常生活里这类数据遍地都是:客单价、停留时长、响应时间、单用户收入、赔付金额——凡是”少数人特别高”的,基本都右偏。
换个数字看,结论就变了
不要只问”平均多少”,要问”排在什么位置“:
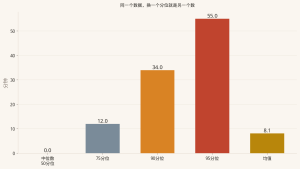
| 分位 | 含义 | 本例 |
|---|---|---|
| 50 分位(中位数) | 一半人在这之下 | 0.0 分钟 |
| 75 分位 | 四分之三的人在这之下 | 12.0 分钟 |
| 90 分位 | 九成的人在这之下 | 34.0 分钟 |
| 95 分位 | 最慢的 5% 从这里开始 | 55.0 分钟 |
如果要对客承诺,应该看 90 分位(34.0 分钟)——它能覆盖九成场景。用均值去承诺,等于默认放弃那 30.2%。
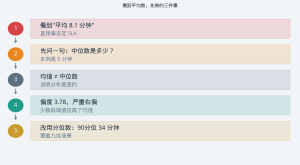
看到平均数,先做三件事
-
问中位数是多少——均值 ≈ 中位数,说明分布对称,用均值没问题;差得远,说明有极端值。
-
看分位数——做承诺、定 SLA,用 90 或 95 分位。
-
看构成——是不是少数极端值在主导?如果是,应该单独处理那一小撮,而不是改整体口径。
什么时候均值仍然好用
不是所有情况都要弃用均值:
-
要算总量时:平均客单价 × 用户数 = 总收入,这里必须用均值,中位数算不出来。
-
分布对称时:比如身高、考试分数(近似正态),均值和中位数差不多。
-
做加减法时:均值可以相加,中位数不行。
判断标准就一句:均值被极端值带偏了吗? 看一眼均值和中位数的差距就知道。
附:可运行代码
数据集:美国运输统计局 BTS 航班延误记录(20,000 条,公开数据)
import pandas as pd, numpy as np
# 载入后取 delay 列
d = df['delay'].dropna()
print('均值 %.2f' % d.mean())
print('中位数 %.2f' % d.median())
print('偏度 %.2f' % d.skew())
# 关键对比:按均值 vs 按中位数承诺
print('按均值承诺,超标比例 %.1f%%' % (100 * (d > d.mean()).mean()))
print('按中位数承诺,超标比例 %.1f%%' % (100 * (d > d.median()).mean()))
# 分位数——做承诺该看这个
for q in [.5, .75, .9, .95]:
print('%-4d 分位 %.1f 分钟' % (q * 100, d.quantile(q)))
# 构成:谁把均值拉高了
print('延误 >60 分钟占比 %.1f%%' % (100 * (d > 60).mean()))跑一遍你会看到:均值 8.1、中位数 0.0、偏度 3.78,以及按均值承诺仍有 30.2% 超标。
如果你也在做类似的东西,欢迎交流,我这边有完整实现,可以发你参考。
