辛普森与异质性:合并看 17.2pp,拆开看是 34.2 / 29.6 / 11.6,合并值对谁都不适用
数据:IBM / UCI Telco Customer Churn 电信客户流失(7,043 条,公开数据)(公开数据集,可自行下载复现)
先看一个场景
分析师汇报:“高月费客户的流失率,比低月费客户高 17.2 个百分点。”
结论听起来很清楚:高价导致流失,该降价了。
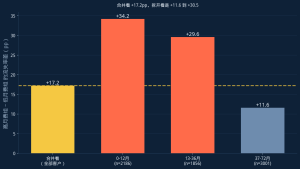
新客(0-12 月):高月费比低月费流失高 34.2pp
中客(13-36 月):高 29.6pp
老客(37-72 月):高 11.6pp
合并的 17.2pp,是新客 34.2pp 和老客 11.6pp 平均出来的。对任何一类客户,它都不是准确答案。
用真实数据看
数据:7,043 名电信客户。按”在网时长”分成三层,每层内部再比高月费 vs 低月费:
| 分层 | 客户数 | 低月费流失 | 高月费流失 | 差距 |
|---|---|---|---|---|
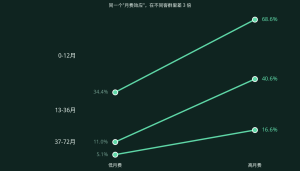
| 0-12月 | 2,186 | 34.4% | 68.6% | +34.2pp |
| 13-36月 | 1,856 | 11.0% | 40.6% | +29.6pp |
| 37-72月 | 3,001 | 5.1% | 16.6% | +11.6pp |
| 合并(全部) | — | 17.9% | 35.1% | +17.2pp |
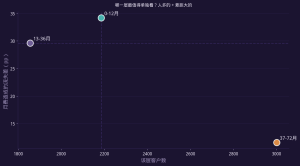
合并值 17.2pp 落在中间,但三层的真实差距从 11.6 到 34.2,跨了将近 3 倍。
为什么会这样
因为高月费客户在各层的分布不均匀。
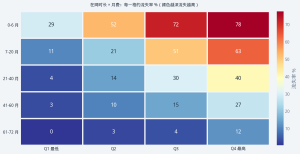
新客集中在新套餐(月费高),老客多在老套餐(月费低);而新客本身就容易流失。所以”高月费”和”新客”这两个因素缠在一起,合并看就把它们混成了一个数。
这张热力图把两个维度交叉起来,每个格子的流失率一目了然。光看一行或一列,都会丢掉一半信息。
合并值不是”错”,是”混”
这一点要说清楚:
合并值 17.2pp  —— 描述"整体平均而言",没错
分层值 34.2/29.6/11.6pp —— 描述"具体到某类客户",更准
问题出在:把合并值当成对具体群体的结论去用。
对老客说”你们高月费客户流失风险高 17.2pp”,实际只有 11.6pp——会过度反应;对新客说同一句话,实际是 34.2pp——会低估严重性。
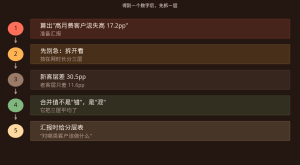
得到一个数字后,先拆一层
-
拿到合并结论,先别急着用
-
找一个可能的分层维度(时间、渠道、客群、地区……)
-
每层重算一遍
-
看层间是否一致:一致 → 合并值可以用;不一致 → 必须分层说
-
汇报时给分层表,而不是一个数
第 4 步是判断标准:如果分层后数字差不多,合并值是安全的;差得远,合并值就是在误导。
什么时候该合并
合并不是原罪:
-
要做总量预测时:总收入 = 各层之和,合并口径更简单
-
层间差异小时:合并值节省沟通成本
-
层分不动时:某层样本太少,分层后误差更大(见 00C)
判断依据还是那句:拆开看,差得远吗?
附:可运行代码
数据集:IBM / UCI Telco Customer Churn 电信客户流失(7,043 条,公开数据)
import pandas as pd
df['churn'] = (df['Churn'] == 'Yes').astype(int)
med = df['MonthlyCharges'].median()
# 1. 合并看
hi = df[df['MonthlyCharges'] >= med]['churn'].mean()
lo = df[df['MonthlyCharges'] < med]['churn'].mean()
print('合并:高月费 %.1f%% 低月费 %.1f%% 差 %+.1fpp'
% (100*hi, 100*lo, 100*(hi-lo)))
# 2. 分层看
df['tenure_grp'] = pd.cut(df['tenure'], [-1, 12, 36, 72],
labels=['0-12月', '13-36月', '37-72月'])
for name, sub in df.groupby('tenure_grp', observed=True):
h = sub[sub['MonthlyCharges'] >= med]['churn'].mean()
l = sub[sub['MonthlyCharges'] < med]['churn'].mean()
print('%-8s n=%4d 差 %+.1fpp' % (name, len(sub), 100*(h-l)))跑一遍你会看到:合并 +17.2pp,分层后是 +34.2 / +29.6 / +11.6pp。
如果你也在做类似的东西,欢迎交流,我这边有完整实现,可以发你参考。
