栏目:取数提效 | 标签:AI写SQL、SQL校验、JOIN、提示词、数据口径
关于本文的数据说明
文中的表结构(orders 1,000 行、order_items 平均 3.2 行/单)与放大倍数(3.2 倍)是构造的示意数据,用于讲清 JOIN 粒度问题。三个检查点、校验方法与提示词模板是通用的,可直接套用。
上一篇文章讲了怎么用 AI 把”人话”变成 SQL。
这篇讲一件更要紧的事:它生成的查询能跑通,不代表算出来的数是对的。
先看一个生活里的版本
你用翻译软件翻一句中文给外国客户看:
“我们这款产品,用过的都说好。”
翻译软件给出:
“Our product, those who have used it all say it’s good.”
语法完全正确,没有一个错词,读起来也通顺。 但它想表达的”口碑好”变成了”用过的人都在夸”,语气从自信变成了夸张,外国客户读完的感觉和你想给的完全不一样。
问题出在哪?翻译软件不知道这句话要用来干什么。 它不知道对方是谁、不知道你想传达什么语气、不知道”说好”在你的语境里是”满意度高”还是”复购率高”。
所以它选了一个语法上成立、语义上偏离的默认值,然后继续往下翻。
AI 写 SQL 在做完全一样的事。
它不知道你的 orders 表和 order_items 表是一对多关系,不知道你的时间字段存的是 UTC,不知道你那个 NULL 在业务上代表”没记录”还是”没有”。它会选一个技术上成立的默认值,然后继续往下写。
结果:SQL 能跑,数字全错。
一、这是两种完全不同的失败
值得先把这两种失败分开,因为它们的处理方式完全不同:
| 跑不通 | 跑通了但算错 | |
|---|---|---|
| 什么时候发现 | 立刻 | 可能永远发现不了 |
| 谁会发现 | 数据库 | 没人 |
| 后果 | 浪费 5 分钟 | 数字一路走到汇报材料里 |
跑不通的查询会立刻报错,你改一下就好。
跑通了但算错的查询,会一路走到汇报材料里——被做成图表,被拿去决策,最后被追溯时,没人记得它来自一段提示词。
所以这篇文章讲的三个检查点,价值不在于”提高 SQL 水平”,而在于挡住第二类失败。
二、检查点 ①:JOIN 有没有把行数放大
这是头号杀手,也是最容易发生的。
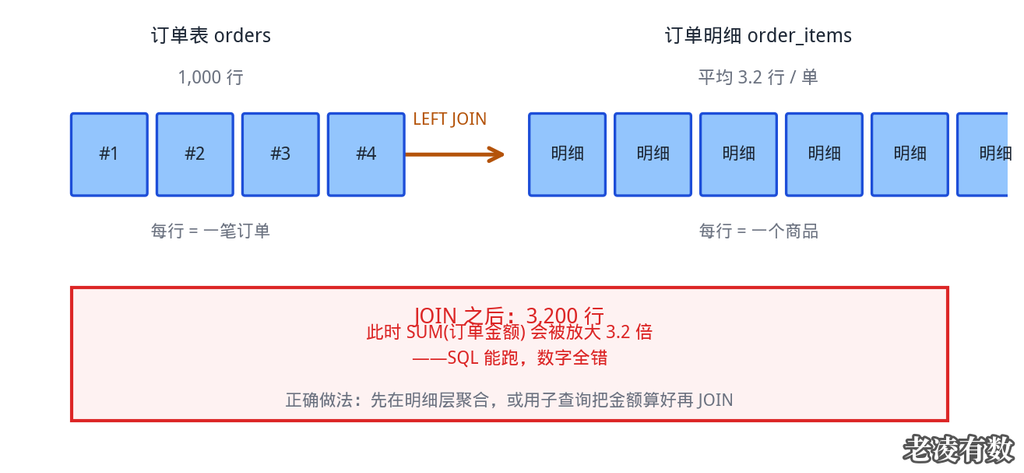
图 1 | 1,000 笔订单 JOIN 明细表之后变成 3,200 行
假设你有两张表:
orders          1,000 行     每行 = 一笔订单
order_items     平均 3.2 行/单   每行 = 一个商品
这是一对多关系。当你把它们 JOIN 起来:
SELECT AVG(o.amount)
FROM orders o
LEFT JOIN order_items i ON o.id = i.order_id
结果集变成 3,200 行。 而订单金额 o.amount 是订单级的字段,它被重复计算了 3.2 次。
于是 AVG(o.amount) 和 SUM(o.amount) 全部失真。
看三种写法的结果对比:
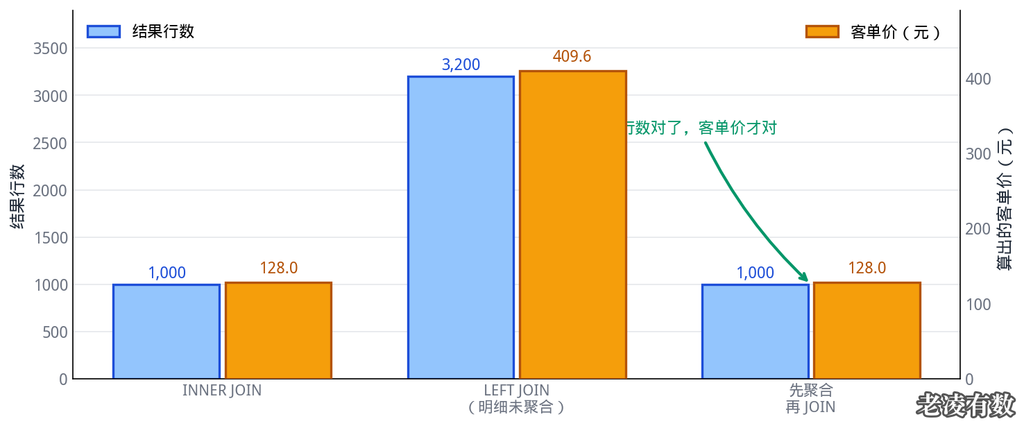
图 2 | 行数对了,客单价才对
| 写法 | 结果行数 | 算出的客单价 |
|---|---|---|
| INNER JOIN(直接连) | 1,000 | 128.0 元 ✅ |
| LEFT JOIN 明细未聚合 | 3,200 | 409.6 元 ❌ |
| 先聚合再 JOIN | 1,000 | 128.0 元 ✅ |
注意第二个:客单价被放大了 3.2 倍。
而这个错误没有任何症状——查询正常执行,返回的也是一个”合理”的数字(409.6 元看起来就是个客单价)。它唯一的破绽是结果行数不等于 1,000。
所以检查方法极其简单:
跑完之后看一眼结果行数。 如果它不等于你预期粒度下的行数,一定是 JOIN 放大了。
不需要懂执行计划,不需要看图,就数一下行数。
正确写法:先把明细层聚合到订单粒度,再 JOIN;或者用子查询把金额算好。
-- 先聚合,再 JOIN
WITH item_agg AS (
  SELECT order_id, COUNT(*) AS item_cnt
  FROM order_items GROUP BY order_id
)
SELECT AVG(o.amount)
FROM orders o
LEFT JOIN item_agg a ON o.id = a.order_id
三、检查点 ②:时间范围与时区边界
第二个高发区,尤其在跨时区业务和月末季末报表里。
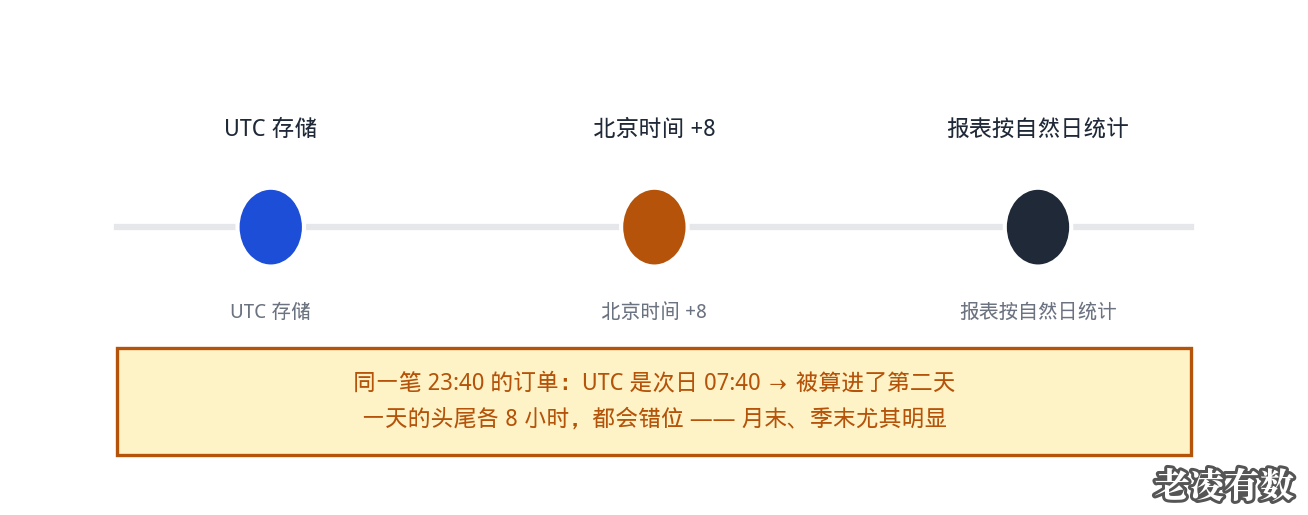
图 3 | 同一笔订单,在 UTC 和北京时间下被算进了不同的日子
假设数据库里的时间字段存的是 UTC,而你的报表按北京时间(UTC+8)的自然日统计。
一笔发生在北京时间 23:40 的订单,在 UTC 里是次日 07:40。
于是:
- 按 UTC 统计:它被算进了第二天
- 按北京时间统计:它属于今天
一天的头尾各 8 小时,都会错位。
这个错误的特点是:它只在边界上出错。 中间 8 小时的数据都是对的,所以你抽查几条记录看不出问题。只有当天结束做汇总时,才会发现”今天的总数好像少了一点”。
而月末、季末尤其致命——因为一个月的第一天和最后一天全部错位,直接影响月报的准确性。
检查方法:
- 确认时间字段的时区:
SELECT NOW()和SELECT UTC_TIMESTAMP()对比一下就知道了。 - 显式声明时区,不要依赖数据库默认:WHERE created_at >= ‘2026-09-01 00:00:00’ AT TIME ZONE ‘UTC’
- 边界对一次:取一天的第一笔和最后一笔,看它们落在哪一天。
顺带说一句:AI 特别容易在这里出问题,因为它在生成 WHERE created_at BETWEEN ... AND ... 时,通常不会主动处理时区——除非你在提示词里明确写了。
四、检查点 ③:NULL 与去重
第三个检查点,也是业务含义最深的一个。
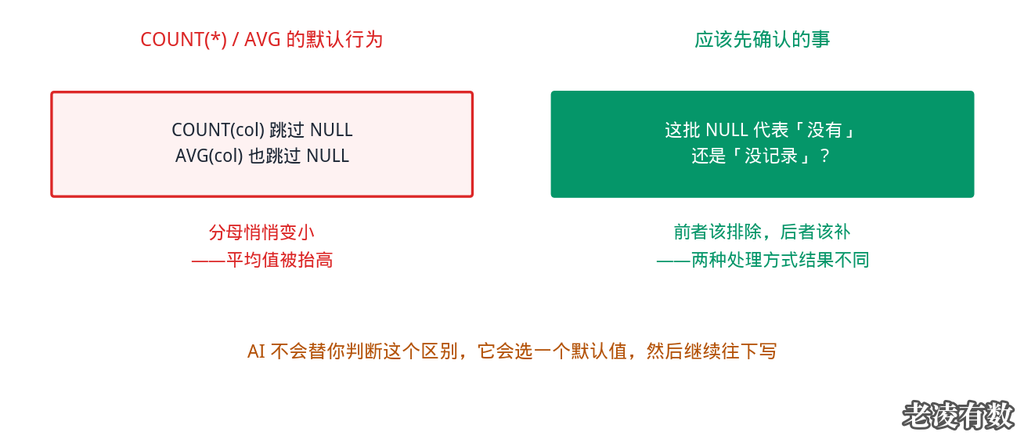
图 4 | “没有”和”没记录”,处理方式完全不同
SQL 的默认行为:
COUNT(col)—— 跳过 NULLAVG(col)—— 跳过 NULL(分母也变小了)SUM(col)—— 跳过 NULL
问题在于:NULL 在业务上到底代表什么?
两种可能:
可能一:这个字段”没有值”。 比如”优惠券码”,用户没用券就是 NULL。这种情况跳过是对的。
可能二:这个字段”没记录到”。 比如”上次登录时间”,用户登过但埋点丢了。这种情况跳过会系统性偏高平均值——因为丢失的那部分通常是低活跃用户。
这两种情况的处理方式完全相反,而 AI 不会替你判断——它会选一个默认值(通常是跳过),然后继续往下写。
去重也是同理:
“去重”按哪个键?按人还是按设备?
同一个人用手机和电脑各访问一次:
- 按
user_id去重 = 1 次 - 按
device_id去重 = 2 次
两个数字都对,但它们的分母不同。AI 会选一个它认为合理的,通常不会问你。
检查方法只有一个:在提示词里把口径写死。
【空值处理】coupon_code 为 NULL 表示用户未使用优惠券,
            统计使用率时应计入分母。
【去重口径】按 user_id 去重,不按 device_id。
顺带说一个第四类问题:聚合层级搞错了
前三个检查点覆盖了绝大多数情况,但还有一类常见错误值得单独提:聚合层级错误。
典型场景是”算人均”。比如你要算”人均订单数”,正确的算法是:
-- 正确:先各自聚合,再相除
SELECT SUM(order_cnt) / COUNT(DISTINCT user_id) FROM per_user_summary
而容易写错的版本是:
-- 错误:先 AVG 再 AVG
SELECT AVG(order_cnt) FROM orders_per_user
这两个在数学上不一样吗?如果用户下单次数都是 1 次,它们相等;但只要有人下了多单,就有差别。
更常见的错误版本是”人均客单价”:
❌ AVG(每个用户的平均订单金额)   ← 用户级别的均值
✅ SUM(总金额) / COUNT(DISTINCT 用户数)  ← 真正的"人均"
前者给每个用户相同的权重,后者给每笔金额相同的权重。 一个下单 20 次的大客户,在第一种算法里和只下单 1 次的小客户权重相同——于是结果会被小客户拉低。
这类错误的隐蔽性在于:它不需要 JOIN,也不涉及时间,纯粹是一个”先除还是后除”的选择。 而 AI 在生成时通常不会主动说明它选了哪种。
检查方法:凡是出现”人均””每用户””每次”这类词,就在提示词里明确写出计算式,不要只写指标名。
五、三个检查点,两分钟
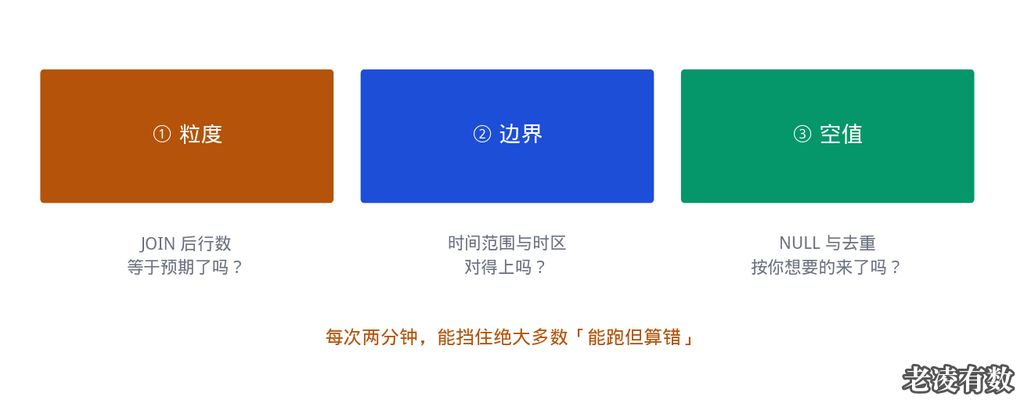
图 5 | 每次两分钟,能挡住绝大多数”能跑但算错”
完整流程是这样:
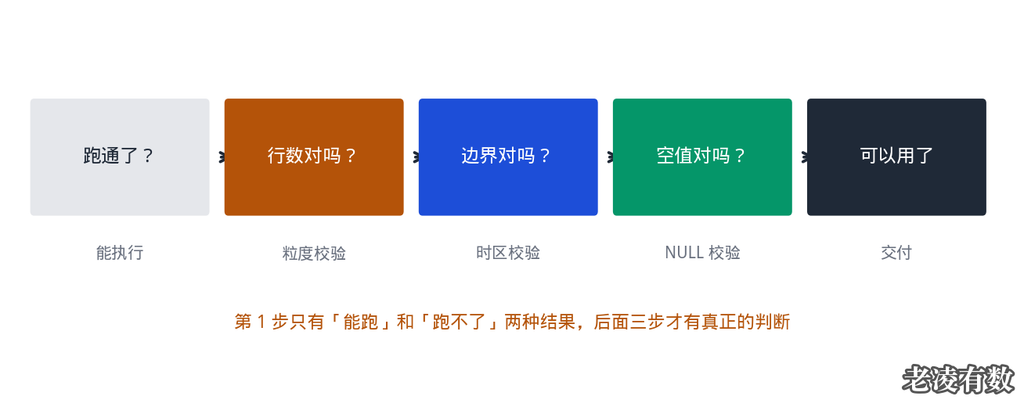
图 6 | 第 1 步只有”能跑/跑不了”,后面三步才有真正的判断
① 粒度:结果行数等于预期粒度下的行数吗? ② 边界:时间范围与时区对得上吗? ③ 空值:NULL 与去重按你想要的来了吗?
六、一个可以直接复制的校验提示词
把下面这段接在生成 SQL 的提示词后面,让 AI 自己先过一遍:
在给出 SQL 之前,请先回答下面 4 个问题。
如果你无法确定答案,请明确说明"需要确认",
不要自行假设。
1. 【粒度】主表与每个 JOIN 的表分别是什么粒度?
JOIN 之后的行数,会不会大于主表行数?
如果会,你打算如何避免聚合字段被重复计算?
2. 【时区】涉及的时间字段存储的是哪个时区?
统计周期是自然日还是业务日?
周期边界如何界定(含首含尾?)
3. 【空值】参与计算与去重的字段中,哪些可能为 NULL?
NULL 在业务上代表"没有值"还是"未记录"?
两种情况下的处理方式分别是什么?
4. 【去重】如果需要去重,按哪个键?
按 user_id 还是 device_id 还是 session_id?
为什么这个选择符合统计目的?
回答完之后,再给出 SQL,并在 SQL 注释中标注
你对上面每个问题做的假设。
最后那句”在注释中标注你的假设“是关键——它把 AI 的隐式默认值显式化了。你可以一眼看出它在哪里替你做了决定,然后决定接不接受。
七、交付之前过这 6 关
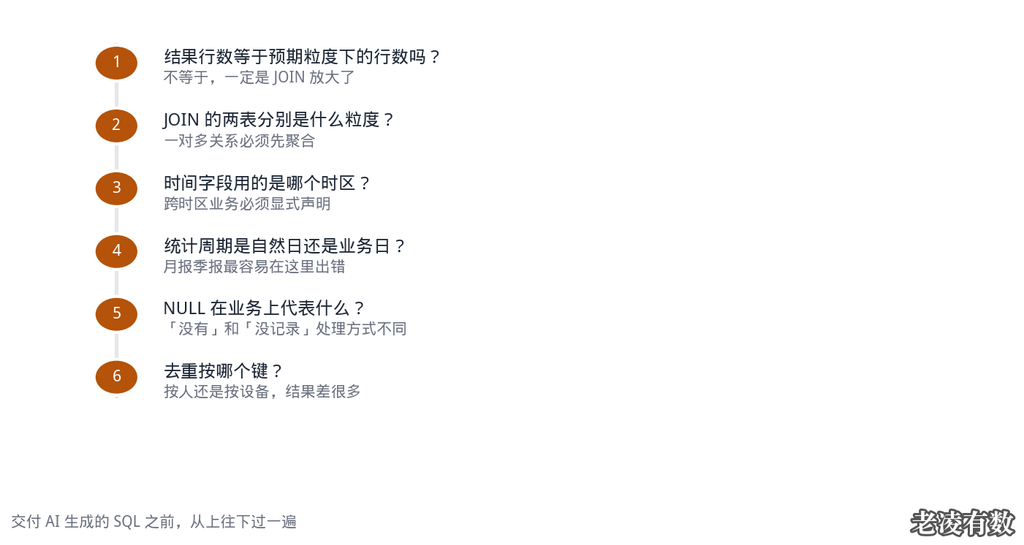
图 7 | 交付 AI 生成的 SQL 之前,从上往下过一遍
- 结果行数等于预期粒度下的行数吗?(不等于,一定是 JOIN 放大了)
- JOIN 的两表分别是什么粒度?(一对多关系必须先聚合)
- 时间字段用的是哪个时区?(跨时区业务必须显式声明)
- 统计周期是自然日还是业务日?(月报季报最容易在这里出错)
- NULL 在业务上代表什么?(”没有”和”没记录”处理方式不同)
- 去重按哪个键?(按人还是按设备,结果差很多)
第 1 条最省事也最有效:数一下行数。 这一个动作能挡掉一半以上的错误。
顺带说一句:让 AI 自己检查自己
最后给一个能省力的技巧:把校验也交给 AI,但要求它把假设写出来。
很多人用 AI 写 SQL 的流程是”生成 → 自己检查”。而更高效的流程是”生成 → 让 AI 自查 → 你只看它列出的假设”。
具体做法是在生成之后追加一句:
请检查你刚才写的这段 SQL,并回答:
1. 结果集的行数会等于哪个粒度下的行数?会不会被放大?
2. 涉及的时间字段是什么时区?周期边界如何界定?
3. 参与计算的字段中哪些可能为 NULL?你做了什么假设?
4. 你在这段 SQL 里做了哪些我没有明确说明的假设?逐条列出。
第 4 条最关键。 它会逼 AI 把自己沉默做过的决定列出来——而这正是你最需要审查的部分。
注意:这不是让它替你负责。 它列出来的假设仍需你自己判断对错。但它把”隐藏的默认值”变成了”显式的清单”,你的检查工作从”通读整段 SQL 找问题”变成了”逐条确认 5 个假设”——工作量差了一个数量级。
最后一句
回到翻译软件那个例子。
它翻出来的句子语法全对,但意思偏了。你之所以能发现问题,是因为你懂中文,也知道你想表达什么——你能对照原文检查。
AI 写的 SQL 也是一样:它能被检查,前提是你知道正确的答案应该长什么样。
所以这三个检查点,本质上不是”SQL 技巧”,而是三件只有你知道、AI 不知道的事:
- 你的表之间是什么关系(业务结构)
- 你的时间是怎么定义的(统计口径)
- 你的 NULL 代表什么(业务含义)
这三件事,AI 永远猜不对,因为它不在你的公司里。
而把它们写进提示词,是把 AI 从”一个会猜的助手”变成”一个能用的工具”的唯一方法。
AI 能替你写代码,但不能替你承担口径。 口径这件事,永远得有人签字。
拍板之前,先过这 10 关
我做了一份《数据决策 10 问清单》。10 个问题,帮你在为一个数据结论拍板之前,先确认它能不能信——尤其是当这个结论要花掉真金白银的时候。
👉 访问 archcode.cn 免费领取 | 公众号后台回复「10问」
如果你手上正有一份报告拿不准,也可以直接找我:发过来,我出 3 页诊断意见。